Quando gestiamo architetture web complesse o portali caratterizzati da decine di migliaia di richieste al minuto, affidarsi esclusivamente alle metriche aggregate fornite dai cruscotti commerciali rappresenta una pericolosa semplificazione. Molti operatori trascurano il fatto che il traffico parassita, generato da scraper aggressivi, botnet distribuite o simulatori di user-agent non autorizzati, consuma cicli CPU preziosi e degrada la reattività del database, compromettendo di riflesso l'efficienza con cui i motori di ricerca scansionano le pagine strategiche. Il divario informativo tra ciò che accade sulla CDN e ciò che raggiunge effettivamente l'origine può essere colmato soltanto integrando le tracce grezze in una procedura analitica centralizzata.
Menu di navigazione dell'articolo
- Anatomia dei formati di log tra edge layer e server di origine
- Architettura streaming in Python per l'elaborazione ad alta efficienza
- Rilevazione analitica delle anomalie nel comportamento dei bot
- Ottimizzazione del crawl budget e correlazione con le performance SEO
- Bibliografia
- FAQ
In questo approfondimento tecnico vediamo come progettare ed eseguire una pipeline scalabile interamente scritta in Python, orientata al parsing streaming dei log di Nginx e Cloudflare per individuare le discrepanze di comportamento dei bot. Attraverso espressioni regolari ottimizzate, verifica dinamica del reverse DNS, aggregazioni vettoriali e monitoraggio puntuale dei codici di stato, trasformeremo milioni di stringhe non strutturate in indicatori azionabili. Questo approccio ingegneristico si rivela cruciale nella realizzazione di siti web performanti, dove la difesa del server e la gestione millimetrica del crawl budget determinano il successo organico del progetto.
Anatomia dei formati di log tra edge layer e server di origine
Decodifica del combined log format di Nginx e arricchimento con metriche temporali
Il punto di partenza naturale per qualsiasi indagine forense o analisi SEO tecnica risiede nel formato dei registri di Nginx. Di default, la direttiva standard combined include campi classici quali l'indirizzo IP del client, la data e l'ora, il verbo HTTP, il percorso richiesto, il codice di risposta, i byte trasferiti, l'header Referer e la stringa dello User-Agent. Tuttavia, limitarsi a questa configurazione basilare significa operare alla cieca rispetto ai colli di bottiglia architetturali: non è possibile, infatti, discernere se una latenza elevata sia dipesa dalla computazione del codice applicativo o dalla congestione del socket di rete.
Per trasformare il registro in un dataset diagnostico di alto livello, è imperativo ridefinire la direttiva log_format all'interno del blocco http del file nginx.conf, incorporando variabili temporali e identificatori di connessione. Una configurazione avanzata prevede l'aggiunta di $request_time (il tempo totale trascorso dalla ricezione del primo byte del client fino all'invio dell'ultimo byte di risposta), $upstream_response_time (la durata del colloquio tra Nginx e l'interprete PHP-FPM o Node.js), $pipe e il supporto nativo per i protocolli moderni come $server_protocol (essenziale per mappare l'uso di HTTP/2 o HTTP/3).
Quando Nginx opera posizionato dietro a un reverse proxy come Cloudflare, l'IP remoto registrato nella variabile standard $remote_addr corrisponderà a un indirizzo dell'infrastruttura edge anziché all'effettivo client sorgente. Per ripristinare la trasparenza analitica, si deve configurare il modulo ngx_http_realip_module mediante le direttive set_real_ip_from valorizzate con i blocchi CIDR ufficiali della CDN e impostare real_ip_header CF-Connecting-IP;. In alternativa, è possibile registrare esplicitamente l'header $http_cf_connecting_ip e l'identificatore univoco $http_cf_ray, consentendo una correlazione biunivoca infallibile tra log locali e registri perimetrali.
Struttura dei dataset JSON di Cloudflare Logpush e mapping delle intestazioni edge
Cloudflare intercetta le richieste prima che esse sfiorino il data center di destinazione, memorizzando in cache le risorse statiche e applicando regole crittografiche o di mitigazione DDoS. L'accesso a questi eventi mediante il servizio Logpush consente di scaricare batch compatti in formato JSONLines, spesso salvati su bucket S3 compatibili o storage distribuiti. A differenza della stringa testuale di Nginx, ogni riga di Logpush è un dizionario autosufficiente contenente decine di parametri cruciali per l'analisi dei bot.
I campi cardine da mappare nella pipeline Python includono ClientIP, ClientRequestURI, ClientRequestUserAgent, EdgeResponseStatus, EdgeStartTimestamp, BotScore e BotManagement.CorporateProxy. Di particolare rilievo per la sicurezza e la SEO è il campo BotScore: un valore intero compreso tra 1 e 99 generato dai modelli euristici di Cloudflare, dove i valori inferiori a 30 segnalano attività fortemente automatizzate, mentre valori superiori a 80 indicano con buona probabilità un utente umano o un crawler legittimo certificato.
Un aspetto ingegneristico da considerare nel confronto con Nginx riguarda le richieste che generano risposte 304 Not Modified o che vengono servite integralmente con esito HIT dalla cache edge. Queste transazioni non compaiono affatto nei file di accesso di Nginx se non configurate per un bypass esplicito. Disporre di entrambi i flussi permette di calcolare con precisione metrica il Cache Hit Ratio specifico per i crawler di indicizzazione, verificando se il motore di ricerca consuma risorse sull'origine o se viene soddisfatto istantaneamente al margine della rete.
Architettura streaming in Python per l'elaborazione ad alta efficienza
Generatori di memoria e parsing con espressioni regolari compilate
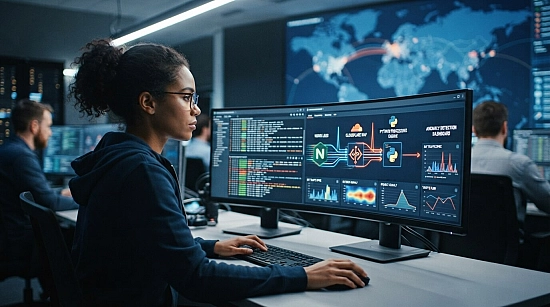
I file di registro prodotti da siti web a medio e alto volume generano quotidianamente svariati gigabyte di dati grezzi. L'errore più comune commesso nei tool di parsing improvvisati consiste nel caricare l'intero file in memoria tramite costrutti quali file.readlines(), portando inesorabilmente a saturazione della RAM e crash per Out-Of-Memory. Per garantire un'elaborazione a consumo costante di memoria, l'architettura in Python deve fondarsi su funzioni generatrici che sfruttano il comando yield per elaborare i record riga per riga in modalità streaming lineare.
L'estrazione dei campi dalla stringa formattata di Nginx richiede l'utilizzo del modulo re, compilando preventivamente l'espressione regolare tramite re.compile(). La pre-compilazione riduce sensibilmente l'overhead computazionale all'interno del loop di scansione. Definiamo una regex che catturi rigorosamente i gruppi denominati per isolare client, timestamp, metodo, URI, codice di stato e tempi di risposta. L'utilizzo di named groups garantisce leggibilità al codice e facilita l'esportazione automatica verso tuple denominate o dizionari snelli.
Consideriamo una sequenza di parsing snella ed efficiente progettata per consumare un flusso di log Nginx:
import re
from typing import Generator, Dict, Any

LOG_PATTERN = re.compile(
    r'^(?P<ip>[\d\.]+) - - \[(?P<time>[^\]]+)\] '
    r'"(?P<method>[A-Z]+) (?P<uri>\S+) HTTP/[123\.]+" '
    r'(?P<status>\d{3}) (?P<bytes>\d+) '
    r'"(?P<referer>[^"]*)" "(?P<agent>[^"]*)" '
    r'(?P<req_time>[\d\.]+) (?P<upstream_time>[\d\.\-]+)$'
)

def stream_log_records(filepath: str) -> Generator[Dict[str, Any], None, None]:
    with open(filepath, 'r', encoding='utf-8', errors='replace') as log_file:
        for line in log_file:
            match = LOG_PATTERN.match(line.strip())
            if match:
                data = match.groupdict()
                data['status'] = int(data['status'])
                data['bytes'] = int(data['bytes'])
                data['req_time'] = float(data['req_time'])
                yield data
Questo schema garantisce che la memoria occupata dal processo rimanga nell'ordine di poche decine di megabyte, indipendentemente dal fatto che il file analizzato sia di cento megabyte o di cinquanta gigabyte. Se i log si presentano compressi con gzip o zstandard, è sufficiente sostituire il context manager con le librerie gzip o zstandard, mantenendo la medesima interfaccia di streaming trasparente.
Scalare l'elaborazione su larga scala: Polars, multiprocessing e parsing non bloccante
Quando il volume dei registri supera decine di milioni di righe al giorno, la computazione a singolo thread in Python diventa inevitabilmente limitata dal Global Interpreter Lock (GIL). Per aggirare questo vincolo e sfruttare appieno i core della macchina, la strategia più efficace consiste nel partizionare i file di log in blocchi (chunk) da demandare a un pool di processi tramite il modulo standard multiprocessing, oppure nel canalizzare i dati strutturati verso librerie vettoriali moderne basate su Apache Arrow come Polars.
Polars offre prestazioni drasticamente superiori rispetto a Pandas nel trattamento di dataset tabulari di grandi dimensioni, grazie al motore interno scritto in Rust, al calcolo parallelo nativo e alla gestione delle espressioni lazy. Invece di iterare manualmente per raggruppare le metriche di traffico, convertiamo l'output generato dai worker in un DataFrame Polars, eseguendo aggregazioni complesse per intervalli temporali, user-agent e classi di codici di risposta in frazioni di secondo.
Nel contesto dell'ingegneria dei sistemi promossa da Enrico Mainero, la costruzione di pipeline analitiche scalabili è uno standard irrinunciabile: trasformare i log in serie storiche consente di correlare i picchi di scansione con l'andamento del tempo di risposta del server (TTFB) e con le modifiche infrastrutturali, individuando tempestivamente eventuali degradazioni del servizio.
Rilevazione analitica delle anomalie nel comportamento dei bot
Tecniche di verifica crittografica e reverse DNS per smascherare i falsi crawler
Uno dei pericoli più insidiosi per qualsiasi infrastruttura digitale è rappresentato dai cosiddetti crawler camuffati: scraper malevoli che dichiarano uno User-Agent identico a Googlebot, Bingbot o Yandex per eludere le restrizioni standard del file robots.txt e aggirare i web application firewall meno sofisticati. Accettare la stringa identificativa come prova di identità è una vulnerabilità architetturale gravissima. La pipeline di log analysis deve implementare una routine rigorosa di convalida crittografica e di rete basata sul doppio lookup DNS (Forward-Confirmed Reverse DNS o FCrDNS).
Il meccanismo FCrDNS si articola in due fasi matematiche consequenziali. In primo luogo, la pipeline estrae l'indirizzo IP associato alla richiesta sospetta ed esegue un lookup PTR (reverse DNS) interrogando i server competenti, ricavando il nome di dominio canonico (come crawl-66-249-66-1.googlebot.com). Successivamente, lo script esegue un lookup diretto di tipo A o AAAA su quel dominio ricavato per ottenere l'elenco degli indirizzi IP corrispondenti. Solo se l'IP iniziale coincide con uno degli IP restituiti dal lookup diretto, il bot può essere certificato come crawler autentico.
Poiché le chiamate DNS sincrone su milioni di righe introdurrebbero una latenza inaccettabile a causa dei tempi di propagazione di rete, la procedura di verifica in Python deve avvalersi di una cache LRU (Least Recently Used) integrata e di un resolver asincrono basato su aiodns o dnspython con pool non bloccante. Memorizzando i prefissi di rete e gli IP già validati, l'impatto sui tempi di elaborazione crolla del 99%, consentendo di marchiare ogni record con un flag booleano di autenticità in tempo reale.
Riconoscimento dei pattern malevoli e analisi dell'entropia di scansione
Una volta isolati i crawler legittimi da quelli falsi, la pipeline deve concentrarsi sulla rilevazione delle anomalie comportamentali. I bot aggressivi mostrano una distribuzione statistica peculiare che differisce nettamente sia dalla navigazione umana sia dalla scansione metodica di Googlebot. Uno dei parametri euristici più efficaci da calcolare è l'intervallo temporale tra richieste consecutive (inter-arrival time) e la deviazione standard della distribuzione dei ritardi: i bot non configurati o gli scraper amatoriali tendono a richiedere centinaia di risorse con intervalli costanti o pressoché nulli, saturando i socket TCP.
Un secondo fattore rivelatore è l'analisi dell'entropia dei percorsi URL richiesti. I crawler di indicizzazione seguono i link canonici e rispettano la struttura gerarchica della sitemap del portale, manifestando una frequenza bilanciata tra categorie, articoli e asset correlati. Gli scraper aggressivi o gli scanner di vulnerabilità automatizzati, al contrario, generano picchi disordinati di richieste verso endpoint inesistenti (generando cluster di errori 404), tentano il brute-force di parametri di query o forzano percorsi di backend noti (come /wp-login.php, /.env o /actuator/health).
La nostra pipeline Python aggrega i dati su finestre scorrevoli temporali (rolling windows) di 5 o 15 minuti, calcolando l'indice di Shannon per la diversità degli URI richiesti per singolo IP o subnet /24. Qualora l'entropia scenda sotto una determinata soglia in concomitanza con un volume anomalo di codici di risposta 4xx o 5xx, il sistema esporta automaticamente l'indirizzo IP all'interno di una blocklist dinamica, sincronizzabile con le Firewall Rules di Cloudflare tramite API REST o inviabile a un demone Fail2ban sul nodo Nginx di produzione.
Ottimizzazione del crawl budget e correlazione con le performance SEO
Gestione strategica degli header HTTP e impatto delle risorse sul rendering del DOM
Il tempo che gli spider dei motori di ricerca dedicano a un sito web prima di abbandonare l'esplorazione è una risorsa finita, definita comunemente crawl budget. Nei sistemi ricchi di contenuti dinamici, un'architettura dei log trasparente rivela con precisione chirurgica quali risorse dissipano questa quota. Esaminando le estensioni di file e le intestazioni di risposta, scopriamo regolarmente spider che impiegano oltre il 40% delle loro sessioni a scaricare file multimediali pesanti, script JavaScript complessi o stylesheet che non hanno subito modifiche dall'ultima visita.
L'ingegnerizzazione degli header di risposta diventa quindi un'arma primaria di ottimizzazione. La presenza di un corretto header ETag e di una direttiva Cache-Control ben calibrata permette a Nginx di rispondere immediatamente con un codice di stato 304 Not Modified alle richieste condizionate (inviate con header If-None-Match o If-Modified-Since). La differenza prestazionale è colossale: una risposta 304 invia pochi byte di intestazioni ed evita l'esecuzione dell'interprete applicativo, salvaguardando il crawl budget e riducendo a pochi millisecondi il tempo di risposta del server.
Parallelamente, il parsing dei log permette di studiare l'impatto delle differenti modalità di rendering sulle routine di crawling. I test sui server mostrano che quando un'applicazione fa largo uso di Client-Side Rendering (CSR), lo spider è costretto a richiedere molteplici bundle JavaScript per eseguire il rendering del DOM in una seconda fase (il cosiddetto render queue). Con il Server-Side Rendering (SSR) o la Static Site Generation (SSG), il log attesta che il crawler ottiene l'intero contenuto semantico ed essenziale con una singola richiesta HTTP 200, riducendo drasticamente il carico computazionale sull'infrastruttura di indicizzazione.
Correlazione empirica tra frequenza di scansione, risposte del server e ranking
L'integrazione di un'infrastruttura di analisi avanzata dei log permette di andare oltre la mera diagnosi di sicurezza, creando modelli di regressione e correlazione statistica tra la frequenza di visita dei crawler ufficiali e le fluttuazioni di ranking nelle pagine dei risultati dei motori di ricerca. Una metrica determinante emersa dall'osservazione dei flussi su grandi aggregati editoriali è il cosiddetto crawl delay dinamico: all'aumentare dei tempi di risposta dell'upstream (visibili nel campo $upstream_response_time di Nginx), la velocità con cui i bot visitano nuovi documenti cala drasticamente.
Attraverso script Python dedicati, possiamo quantificare la correlazione di Pearson o di Spearman tra i seguenti fattori analitici:
- Tempo medio di risposta del server (TTFB) aggregato per cluster di percorsi logici.
- Percentuale di risposte HTTP con errore 500, 502 o 504 nel corso della giornata.
- Frequenza giornaliera di hit da parte dei Googlebot certificati su URL appena pubblicati o aggiornati.
- Tempo intercorso tra la prima scoperta del documento nei log e la sua comparsa effettiva nell'indice.
Quando il web server risponde con costanza al di sotto della soglia dei 200 millisecondi e azzera gli errori transitori di timeout, si riscontra una contrazione evidente del tempo di indicizzazione, accompagnata da un aumento del numero di URL scansionati nelle ore di punta. L'analisi applicata dimostra che gli spider dei motori di ricerca modulano la propria aggressività di scansione in base alla stabilità del server: se l'infrastruttura dimostra solidità ingegneristica, il crawler espande l'esplorazione dei contenuti profondi, trasferendo più rapidamente la link equity all'intera alberatura del sito.
Bibliografia
- José Manuel Ortega - Mastering Python for Networking and Security
FAQ
Come posso gestire i file di log compressi in cluster distribuiti senza saturare la banda di rete locale?
Nelle architetture distribuite composte da decine di istanze computazionali, trasferire costantemente file di log non compressi verso un server di aggregazione centrale genera un sovraccarico di rete insostenibile e introduce colli di bottiglia nei dischi. La strategia raccomandata prevede l'impiego di agent leggeri di spedizione o script Python eseguiti sul nodo periferico (edge o worker) che operano in modalità streaming direttamente sopra flussi compressi, preferibilmente con standard moderni ad alta compressione e decompressione rapida come zstandard (zstd) o gzip con compressione a blocchi. L'approccio ideale consiste nell'elaborare un pre-parsing in loco: estrarre solo i campi d'interesse (ad esempio IP, timestamp, URI, status e response time) e serializzarli in formati binari compatti, come Apache Parquet o JSON compresso a blocchi, prima di inviarli verso uno storage centrale come S3 o un database orientato alle colonne. In alternativa, l'adozione di Cloudflare Logpush con destinazione cloud storage elimina del tutto il traffico locale per la parte perimetrale, consentendo ai nodi analitici di processare i chunk in parallelo direttamente dal bucket cloud tramite connessioni interne ad alta velocità.
Quali rischi comporta l'uso esclusivo degli indirizzi IP per bloccare i crawler malevoli e come superarli?
Affidarsi unicamente al filtraggio rigido degli indirizzi IPv4 per contrastare bot indesiderati o scraper comporta gravi rischi collaterali, a partire dal blocco involontario di utenti legittimi attestati dietro a indirizzi IP nattati (CGNAT), proxy aziendali, nodi VPN condivisi o gateway universitari. Inoltre, gli aggressori più sofisticati impiegano reti proxy residenziali a rotazione o sfruttano pool sterminati di indirizzi IPv6, rendendo il blocco statico di un singolo IP totalmente inefficace dopo pochi millisecondi. Per superare questa criticità, l'ingegneria dei sistemi raccomanda una difesa a livelli che combini l'analisi dell'indirizzo di rete con il fingerprinting del client. Tecniche avanzate quali l'analisi del cipher suite TLS durante l'handshake (JA3 o JA4 fingerprinting), la validazione dei parametri HTTP/2 (come frame SETTINGS, WINDOW_UPDATE e priorità dei flussi) e la valutazione euristica del comportamento su finestre temporali offrono una precisione di identificazione incomparabilmente superiore. Bloccando o sottoponendo a challenge crittografico (come una verifica JavaScript o un Managed Challenge Cloudflare) l'impronta computazionale del bot anziché il mero IP, si neutralizza la rotazione automatizzata dei proxy preservando intatta l'esperienza dei visitatori reali.