Il passaggio dai protocolli storicamente ancorati allo stack TCP/TLS verso il modello basato su UDP con QUIC, alla base delle specifiche di HTTP/3, rappresenta uno dei cambiamenti architetturali più profondi dell'ultimo decennio. Per decenni abbiamo ottimizzato pipeline di erogazione, architetture del software e sistemi di caching ipotizzando che la latenza del livello di trasporto fosse una costante ineludibile, mitigabile solo tramite la vicinanza geografica delle reti di distribuzione dei contenuti. Nel contesto moderno, l'architettura di rete deve dialogare direttamente con le logiche di scansione automatizzata per garantire che ogni millisecondo risparmiato nel ciclo di trasporto si traduca in una maggiore efficienza operativa.
Menu di navigazione dell'articolo
- Da TCP a UDP: L'architettura del protocollo QUIC e lo smantellamento del Head-of-Line Blocking
- Latenza di Handshaking: Meccaniche 0-RTT e 1-RTT nel ciclo di vita della richiesta
- Comportamento degli User-Agent e negoziazione dei protocolli tramite header Alt-Svc
- Log Analysis e Pipeline di Monitoraggio: Estrazione e Analisi del Traffico HTTP/3
- Bibliografia
- FAQ
Quando analizziamo l'ecosistema dei motori di ricerca, l'efficienza con cui uno spider recupera un documento non dipende unicamente dalle dimensioni del payload o dalla velocità di rendering del Document Object Model. La fase preliminare di instaurazione del canale cifrato, la risoluzione delle dipendenze dei pacchetti e la gestione dei socket concorrenti determinano la soglia di tolleranza con cui i crawler pianificano le richieste successive. Comprendere l'impatto di QUIC e HTTP/3 significa esplorare i meccanismi interni della trasmissione a livello di pacchetto e verificare, tramite metriche oggettive e analisi dei log, come questa transizione rimodelli l'interazione con gli User-Agent ad alta intensità di scansione.
Da TCP a UDP: L'architettura del protocollo QUIC e lo smantellamento del Head-of-Line Blocking
Il superamento dei colli di bottiglia del livello di trasporto in TCP
Il protocollo HTTP/2 aveva introdotto innovazioni straordinarie rispetto a HTTP/1.1, prima fra tutte la possibilità di multiplexare flussi multipli bidirezionali su una singola connessione TCP persistente. Tuttavia, questo approccio condivideva un limite architetturale intrinseco al Transmission Control Protocol: il fenomeno noto come Head-of-Line blocking a livello di trasporto. In HTTP/2, se un singolo pacchetto TCP appartenente a uno specifico flusso viene smarrito lungo la rotta di rete, l'intero buffer di ricezione del socket si arresta in attesa della ritrasmissione e del corretto riordinamento sequenziale dei segmenti.
Questo significa che una risorsa secondaria, come un font o un'immagine non critica, perdendo un pacchetto può congelare temporaneamente l'elaborazione di un file HTML o di uno script fondamentale per l'albero di dipendenze. Su reti con tassi di perdita anche minimi (packet loss compreso tra l'1% e il 2%), le performance complessive di HTTP/2 possono degradare drasticamente, portando a latenze imprevedibili che penalizzano i client automatici progettati per processare migliaia di URI in sequenze temporali serrate durante la scansione di una sitemap xml complessa.
L'integrazione nativa di TLS 1.3 e la serializzazione dei flussi indipendenti
QUIC (Quick UDP Internet Connections) aggira questa barriera strutturale spostando la logica di controllo dello stato, della congestione e dell'affidabilità dallo spazio del kernel (proprio di TCP) allo spazio utente, incapsulando l'intera sessione su datagrammi UDP. In questo contesto, ogni flusso dati all'interno della medesima connessione QUIC opera come un'entità logica totalmente autonoma. La perdita di un datagramma associato a un flusso specifico blocca esclusivamente quel determinato canale, lasciando che gli altri stream proseguano l'elaborazione dei pacchetti senza interruzioni di flusso.
A rendere questa architettura ancora più potente è la fusione indissolubile tra il livello di trasporto e quello crittografico. Mentre in passato TLS veniva applicato come uno strato opaco sopra un socket TCP già stabilito, in QUIC la negoziazione crittografica basata su TLS 1.3 è parte integrante dei pacchetti di connessione. A ciò si affianca l'adozione di QPACK in sostituzione di HPACK per la compressione degli header: QPACK è specificamente progettato per permettere la decodifica delle intestazioni HTTP senza richiedere un ordinamento rigido e sincrono tra flussi eterogenei, eliminando anche i blocchi a livello applicativo.
Latenza di Handshaking: Meccaniche 0-RTT e 1-RTT nel ciclo di vita della richiesta
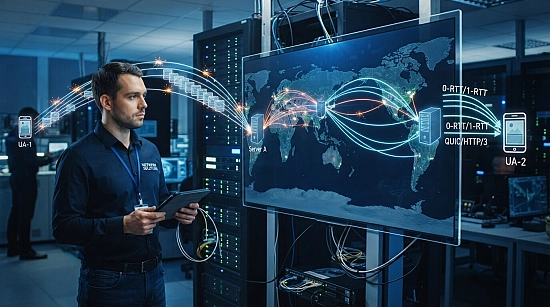
Analisi computazionale del Round-Trip Time tra handshake tradizionale e QUIC
Nel calcolo del costo marginale di una richiesta HTTP verso un'infrastruttura, il parametro più penalizzante su lunghe distanze geografiche è il Round-Trip Time (RTT). Con lo stack classico HTTP/1.1 o HTTP/2 protetto da TLS 1.2, l'avvio di una nuova sessione richiedeva fino a tre completi RTT prima che il client potesse trasmettere il primo byte della richiesta applicativa (un RTT per il three-way handshake TCP SYN/SYN-ACK/ACK, seguito da due RTT per la negoziazione delle chiavi di cifratura TLS). L'avvento di TLS 1.3 ha ridotto questo intervallo a due RTT totali (uno per TCP e uno per TLS).
QUIC abbatte radicalmente questo tempo di setup portandolo a un singolo round-trip (1-RTT) per le connessioni a freddo verso un endpoint mai contattato in precedenza. Durante questo singolo scambio iniziale, il client e il server negoziano contemporaneamente parametri di trasporto, chiavi di cifratura asimmetrica e capacità applicative. L'impatto si amplifica ulteriormente durante la ripresa di sessioni già convalidate (session resumption), dove QUIC abilita la modalità 0-RTT (Zero Round-Trip Time). Con 0-RTT, il client include i dati della prima richiesta HTTP (ad esempio un metodo GET) direttamente all'interno dei primissimi pacchetti inviati al server, crittografandoli tramite i parametri memorizzati nella sessione precedente.
Impatto sui tempi di Time to First Byte (TTFB) e connessioni multi-hop
La contrazione della latenza di negoziazione genera un beneficio diretto sul Time to First Byte (TTFB), una metrica cruciale per valutare l'efficienza di backend e network. Per progetti infrastrutturali articolati, come quelli richiesti nella moderna realizzazione di siti web ad alte prestazioni, il TTFB non misura solo la reattività del codice PHP o Node.js, ma fotografa l'intero tempo trascorso prima che la prima informazione utile varchi la soglia del ricevente.
Nelle architetture multi-hop, dove il traffico attraversa edge server, reverse proxy distribuiti e bilanciatori di carico, eliminare i cicli di handshake ripetuti consente ai motori di calcolo di rispondere istantaneamente. Ciò è particolarmente rilevante per gli spider dei motori di ricerca che operano da data center situati in continenti differenti rispetto all'origine del server. Una riduzione anche di soli 80 millisecondi per singola connessione, moltiplicata per milioni di accessi giornalieri, riduce drasticamente l'impegno computazionale cumulato su scala globale.
Comportamento degli User-Agent e negoziazione dei protocolli tramite header Alt-Svc
Come i bot dei motori di ricerca scoprono e negoziano HTTP/3
A differenza di quanto avvenuto con il passaggio da HTTP/1.1 a HTTP/2, dove l'aggiornamento del protocollo poteva essere negoziato tramite il meccanismo ALPN (Application-Layer Protocol Negotiation) all'interno dell'handshake TLS su porta 443 TCP, HTTP/3 opera su un protocollo di trasporto differente (UDP). Di conseguenza, un client non può dedurre a priori che la destinazione sia raggiungibile via UDP sulla medesima porta. La scoperta avviene tipicamente attraverso un meccanismo di bootstrapping asincrono veicolato dall'header di risposta Alt-Svc (Alternative Services).
Durante la prima interazione con l'host, uno spider come Googlebot effettua una normale richiesta HTTP/2 su TCP. Se il server web è configurato per supportare HTTP/3, restituisce nella risposta un'intestazione specifica:
Alt-Svc: h3=":443"; ma=86400, h3-29=":443"; ma=86400Il parametro ma=86400 (max-age espresso in secondi) istruisce il client a considerare valido il servizio alternativo su UDP per ventiquattro ore. Nelle richieste successive verso quell'autorità, il bot tenterà di stabilire una connessione QUIC diretta, verificando in background se la rotta UDP è aperta e priva di filtri firewall, preservando comunque il canale TCP come fallback trasparente in caso di perdita totale dei pacchetti o blocchi a livello perimetrale.
Frequenza di scansione e throughput: L'impatto sul crawl budget su server ad alto traffico
I motori di ricerca calibrano il volume delle proprie richieste sulla base del cosiddetto crawl budget, che a livello architetturale non è una quota astratta, ma il prodotto tra la capacità di scansione stimata (crawl capacity limit) e la domanda di scansione del sito (crawl demand). La capacità di scansione è direttamente influenzata dai tempi di risposta del server: se l'host risponde rapidamente senza mostrare saturazione di risorse, il crawler incrementa la frequenza di fetch concorrenti per saturare in modo efficiente la banda disponibile.
L'adozione di HTTP/3 riduce drasticamente il numero di socket TCP aperti in stato di attesa (TIME_WAIT o CLOSE_WAIT) sul web server, delegando la gestione dello stato a sessioni QUIC più leggere in termini di descrittori di file del sistema operativo. Inoltre, la combinazione tra connessioni 0-RTT e l'immunità al blocco di testa consente a Googlebot di scaricare le risorse di pagina (CSS, JS, frammenti JSON) a una frequenza notevolmente superiore, accelerando l'intero ciclo di elaborazione e permettendo all'infrastruttura di supportare volumi maggiori di discovery senza incrementare il carico sulla CPU dell'origine.
Log Analysis e Pipeline di Monitoraggio: Estrazione e Analisi del Traffico HTTP/3
Configurazione di Nginx, Cloudflare e pattern di estrazione regex
Per misurare scientificamente l'adozione di HTTP/3 da parte degli User-Agent, è essenziale implementare una configurazione di logging granulare a livello di reverse proxy o server web. In Nginx (a partire dalle release con supporto nativo a ngx_http_v3_module), il formato di log deve essere modificato per registrare la variabile $server_protocol e il tempo di handshake QUIC. Un esempio di direttiva log_format avanzata si articola come segue:
log_format quic_combined '$remote_addr - $remote_user [$time_local] '
                         '"$request" $status $body_bytes_sent '
                         '"$http_referer" "$http_user_agent" '
                         'proto=$server_protocol hshake=$quic_handshake_time '
                         'rt=$request_time uct=$upstream_connect_time';
Una volta raccolti i file di log grezzi, è possibile processarli tramite utility a riga di comando per isolare l'attività degli spider. Con una combinazione di comandi Bash ed espressioni regolari (regex), possiamo estrarre rapidamente il tasso di adozione del protocollo da parte di Googlebot:
grep -E "Googlebot/[0-9\.]+" access.log | awk '{print $9, $10}' | sort | uniq -cIn un contesto di automazione continuativa, uno script Python basato su moduli standard consente di verificare sistematicamente la discrepanza prestazionale tra le richieste servite su HTTP/2.0 e quelle su HTTP/3.0:
import re
from collections import defaultdict

log_pattern = re.compile(
    r'(?P<ip>[\d\.]+) .* "(?P<method>\w+) (?P<uri>\S+) (?P<proto>HTTP\/[\d\.]+)" '
    r'(?P<status>\d+) .* "(?P<ua>.*?)" proto=(?P<srv_proto>\S+) '
    r'.* rt=(?P<req_time>[\d\.]+)'
)

stats = defaultdict(lambda: {"count": 0, "total_time": 0.0})

with open("/var/log/nginx/access.log", "r") as f:
    for line in f:
        match = log_pattern.search(line)
        if match:
            ua = match.group("ua")
            if "Googlebot" in ua:
                protocol = match.group("srv_proto")
                rt = float(match.group("req_time"))
                stats[protocol]["count"] += 1
                stats[protocol]["total_time"] += rt

for proto, data in stats.items():
    avg_rt = data["total_time"] / data["count"] if data["count"] else 0
    print(f"Protocollo: {proto} | Richieste: {data['count']} | RT Medio: {avg_rt:.4f}s")
Correlazione empirica tra velocità di handshake, passaggi di Googlebot e indicizzazione
Dall'analisi sistematica dei log su server ad alta densità di catalogo emergono pattern comportamentali ben definiti. Quando un sito attiva correttamente HTTP/3 e gli User-Agent iniziano a negoziare le sessioni tramite QUIC, si osserva tipicamente una riduzione mediana del tempo di elaborazione delle connessioni dell'ordine del 15-30% sulle aree geografiche distanti dai punti di presenza edge.
Questa efficienza di connessione si correla direttamente a una riduzione del crawl delay implicito applicato dagli algoritmi di Googlebot. Il crawler rileva che l'host risponde senza saturare le code di elaborazione dei pacchetti e incrementa progressivamente il numero di richieste al secondo (fetch rate). Quando questa ottimizzazione di rete viene pianificata all'interno di una strategia strutturata condotta con il supporto di un consulente web esperto, il beneficio non si limita alla velocità pura, ma favorisce l'indicizzazione tempestiva di URL aggiornati di recente, migliorando sensibilmente la freschezza complessiva del portale.
Bibliografia
- Barry Pollard - HTTP/2 in Action
FAQ
In che modo i firewall aziendali e le configurazioni di rete influenzano l'adozione di HTTP/3 da parte dei crawler?
L'adozione di HTTP/3 si scontra talvolta con apparati intermedi (middlebox), firewall perimetrali o policy aziendali che bloccano o limitano fortemente il traffico in uscita sulla porta UDP 443, storicamente considerata suscettibile ad attacchi di tipo UDP amplification o non soggetta a ispezione approfondita dello stato. Dal punto di vista dei crawler commerciali e dei motori di ricerca di primo piano come Google, i sistemi di scansione operano all'interno di reti e data center proprietari privi di questi filtri arbitrari, consentendo loro di sfruttare appieno il trasporto UDP ovunque sia esposto. Tuttavia, qualora un server presenti configurazioni errate nelle tabelle di routing o blocchi perimetrali su UDP, il meccanismo di fallback automatico garantisce che il client torni a interrogare il servizio tramite HTTP/2 su TCP senza interrompere la scansione, pur perdendo i vantaggi in termini di latenza e multiplexing puro.
L'adozione di HTTP/3 apporta benefici diretti al crawling delle risorse statiche bloccanti rispetto a una connessione HTTP/2 persistente?
Sì, il beneficio sul download delle risorse statiche bloccanti (come file JavaScript e CSS critici) è particolarmente marcato in presenza di instabilità di rete o connessioni geograficamente congestionate. In uno scenario HTTP/2 convenzionale, tutte le risorse viaggiano su un unico socket TCP serializzato; se un frammento di un singolo file statico viene smarrito, l'intero flusso di ricezione di tutti gli altri script e stili viene temporaneamente sospeso a causa del vincolo di riordino TCP, rallentando l'avanzamento della pipeline di rendering dello spider. Al contrario, sotto HTTP/3 ogni risorsa statica è veicolata su uno stream QUIC completamente isolato: il verificarsi di un drop di pacchetti su un foglio di stile secondario non impedisce allo spider di completare istantaneamente il download e l'elaborazione del file JavaScript principale, ottimizzando sensibilmente la fase di elaborazione dell'albero di dipendenze del DOM.